چه چیزی می تواند در پشت صحنه ویدئویی ایجاد شود که توسط یک مدل هوش مصنوعی ایجاد شده است؟ ممکن است فکر کنید که این روند شبیه به انیمیشن توقف حرکت است که در آن بسیاری از تصاویر ایجاد شده و دوخته شده اند ، اما این کاملاً برای “مدل های انتشار” مانند Sora of Openal و Veo 2 در Google نیست.
این سیستم ها به جای تولید یک قاب ویدیویی بر اساس قاب (یا “مرجع خودکار”) ، کل دنباله را همزمان پردازش می کنند. کلیپ حاصل اغلب نورپردازی است ، اما روند کند است و اجازه تغییر در حرکت را نمی دهد.
دانشمندان آزمایشگاه علوم کامپیوتر و هوش مصنوعی MIT (CSAIL) و Adobe Research قبلاً یک رویکرد ترکیبی به نام “Causvid” برای ایجاد فیلم در ثانیه ایجاد کرده اند. مانند یک دانش آموز با پیشرفت سریع از یک معلم مشهور ، مدل انتشار کامل ، یک سیستم ضدرسنده خودکار را آموزش می دهد تا در حالی که تضمین کیفیت بالا و قوام دارد ، به سرعت قاب بعدی را پیش بینی کند. الگوی دانشجویی Causvid سپس می تواند فیلم هایی را از یک متن متن ساده تولید کند ، عکس را به یک صحنه در حال حرکت تبدیل کند ، فیلم را گسترش دهد یا خلاقیت های آنها را با ورودی های جدید در وسط نسل تغییر دهد.
این ابزار پویا امکان ایجاد محتوای سریع و تعاملی را فراهم می کند و یک فرآیند 50 مرحله ای را فقط چند اقدام کوتاه می کند. این می تواند بسیاری از صحنه های خیالی و هنری ، مانند یک هواپیمای کاغذی که در یک قو ، ماموت های پشمی که روی برف سوار می شوند ، یا کودکی که به درون یک گودال پرش می کند ، بسازد. مصرف کنندگان همچنین می توانند سریعاً از جمله “ایجاد شخصی که از خیابان عبور می کند” و سپس ورودی های بعدی برای اضافه کردن عناصر جدید به صحنه ، “او را در نوت بوک خود می نویسد.”
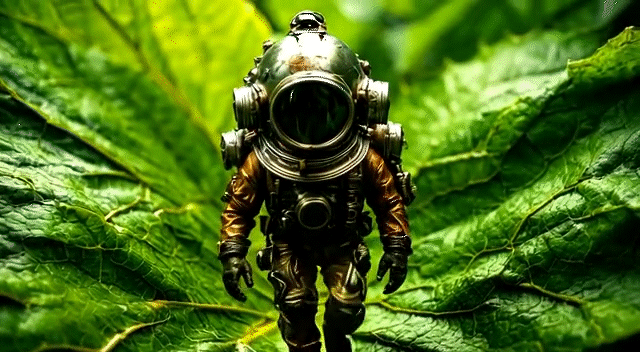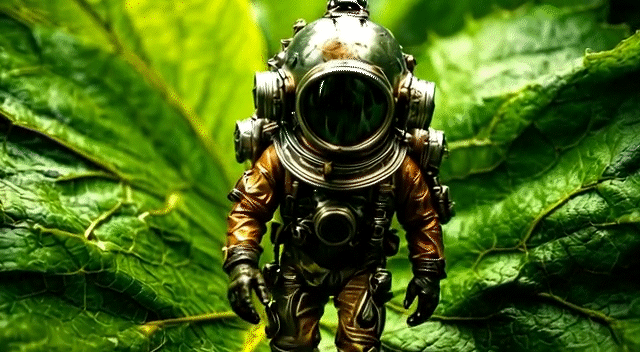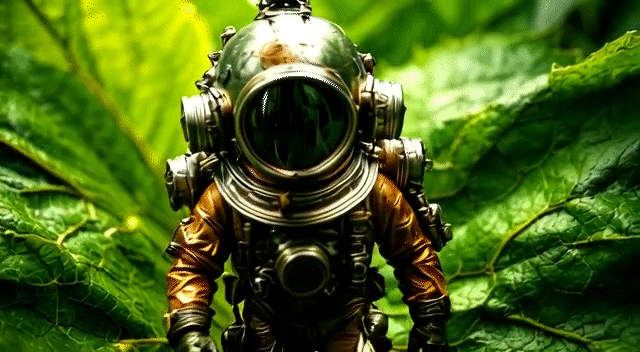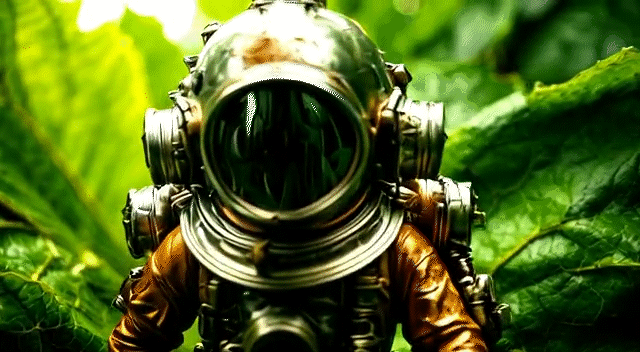
ویدیویی ساخته شده توسط CASVID توانایی آن در ایجاد یک محتوای صاف و با کیفیت بالا را نشان می دهد.
انیمیشن تولید شده توسط هوش مصنوعی ، مهربانی محققان.
محققان CSAIL می گویند که این مدل می تواند برای کارهای مختلف ویرایش ویدیویی استفاده شود ، مانند کمک به بینندگان برای درک زنده به زبان مختلف با تولید ویدیویی که با ترجمه صوتی هماهنگ شده است. این همچنین می تواند به نشان دادن محتوای جدید در بازی های ویدیویی یا ایجاد سریع شبیه سازی های آموزشی برای آموزش کارهای جدید به روبات ها کمک کند.
Tianwei Yin SM ’25 ، دکترا ’25 ، دانشجوی اخیراً فارغ التحصیل مهندسی برق و علوم کامپیوتر و یک شاخه CSAIL ، قدرت مدل رویکرد مختلط را نسبت می دهد.
یین ، نویسنده مشترک کتاب یک کتاب جدید ، می گوید: “Causvid یک مدل انتشار از قبل آموزش دیده را با یک معماری بازپرداخت خودکار ترکیب می کند ، که معمولاً در مدل های تولید متن یافت می شود.” “این مدل از معلم قدرتمند AI ممکن است مراحل آینده را برای قاب به صورت قاب فراهم کند تا از به تصویر کشیدن جلوگیری شود.”
نویسنده مشترک یین ، کیانگ ژانگ ، به تحقیق در XAI و یک محقق مهمان سابق در CSAIL آموزش داده شده است. آنها در این پروژه با تحقیقات Adobe ریچارد ژانگ ، الی شچمن و دانشمندان Xun Huang و دو محقق اصلی CSAIL کار کرده اند: اساتید MIT بیل فریمن و فردو دوراند.
علت (vid) و اثر
بسیاری از مدل های مرجع خودکار می توانند ویدئویی را ایجاد کنند که در ابتدا صاف باشد ، اما کیفیت بعداً در دنباله کاهش می یابد. کلیپی از شخصی که کار می کند ممکن است در ابتدا واقع بینانه به نظر برسد ، اما پاهای آنها در جهات غیر طبیعی از هم پاشیده می شود ، که نشان دهنده اختلافات درون قاب است (همچنین “تجمع خطا” نیز نامیده می شود).
خطاهای ارائه شده از فیلم در رویکردهای علّی قبلی که آموخته اند فریم ها را یک به یک پیش بینی کنند ، متداول است. درعوض ، Causvid برای یادگیری یک سیستم ساده تر از تخصص کلی ویدیویی از یک مدل انتشار با قدرت بالا استفاده می کند ، که به آن اجازه می دهد تا تجسم های صاف ایجاد کند ، اما بسیار سریعتر.

پخش ویدیویی
CASVID امکان ایجاد سریع و تعاملی ویدیویی را فراهم می کند و یک فرآیند 50 مرحله ای را فقط از چند اقدام کوتاه می کند.
ویدیویی از محققان.
Casvid وقتی محققان توانایی وی در ساخت فیلم های با وضوح بالا را ، 10 ثانیه آزمایش کردند ، توانایی خود را در ایجاد فیلم نشان داد. این از خطوط پایه مانند “Opensora” و “Moviegen” فراتر می رود و در حالی که با پایدارترین و با کیفیت ترین فیلم ها تولید می کند ، 100 برابر سریعتر از رقابت خود کار می کند.
یین و همکارانش سپس توانایی CASVID را برای انتشار فیلم های 30 ثانیه ای پایدار آزمایش کردند ، جایی که او همچنین در صدر مدل های کیفیت و قوام قابل مقایسه قرار گرفت. این نتایج نشان می دهد که CauseVID در نهایت می تواند پایدار ، ساعات ساعت یا حتی مدت نامشخص تولید کند.
یک مطالعه دیگر نشان داد که کاربران فیلم های تولید شده توسط الگوی دانشجویی Causvid را نسبت به معلم مبتنی بر انتشار وی ترجیح می دهند.
در می گوید: “سرعت مدل مرجع خودکار اهمیت دارد.” “فیلم های او به همان اندازه معلم به نظر می رسند ، اما با زمان تولید کمتر ، سازش این است که تصاویر بصری وی متنوع تر است.”
Causvid همچنین با آزمایش بیش از 900 با کمک مجموعه ای از متن به فیلم ، با دریافت امتیاز کل 84.27 متفاوت است. او دارای بهترین شاخص ها در دسته هایی مانند تصاویر با کیفیت و اقدامات واقعی انسانی ، تاریک کردن آخرین مدل های تولید ویدیویی مانند “vChitect” و “gen-3” است.
در حالی که یک گام مؤثر در تولید ویدیوی هوش مصنوعی ، ممکن است به زودی به زودی قادر به طراحی تجسم ها حتی سریعتر باشد -با یک معماری علت و جلوه کوچکتر. یین می گوید اگر این مدل در مجموعه داده های خاص دامنه آموزش دیده باشد ، احتمالاً فیلم های با کیفیت بالاتری برای روباتیک و بازی ها ایجاد می کند.
کارشناسان می گویند این سیستم ترکیبی یک نسخه امیدوار کننده از مدل های انتشار است که در حال حاضر از طریق پردازش سرعت در حال غرق شدن هستند. “[Diffusion models] بسیار هیاهو تر از LLMS است [large language models] یا مدل های تولیدی تصویر ، “می گوید: دستیار دانشگاه کارنگی خربزه جون -جون یو ، که در این سند شرکت نکرده است.” این کار جدید در حال تغییر است و فیلم را بسیار کارآمدتر می کند. این به معنای سرعت پخش بهتر ، برنامه های تعاملی بیشتر و چاپ کربن بیشتر است. “
کار این تیم تا حدودی توسط مرکز علمی آمازون ، انستیتوی علوم و فناوری Gwangju ، Adobe ، Google ، آزمایشگاه تحقیقات نیروی هوایی ایالات متحده و شتاب دهنده هوش مصنوعی نیروی هوایی پشتیبانی شد. CASVID در کنفرانس در مورد چشم انداز رایانه و تشخیص تصویر در ماه ژوئن ارائه می شود.