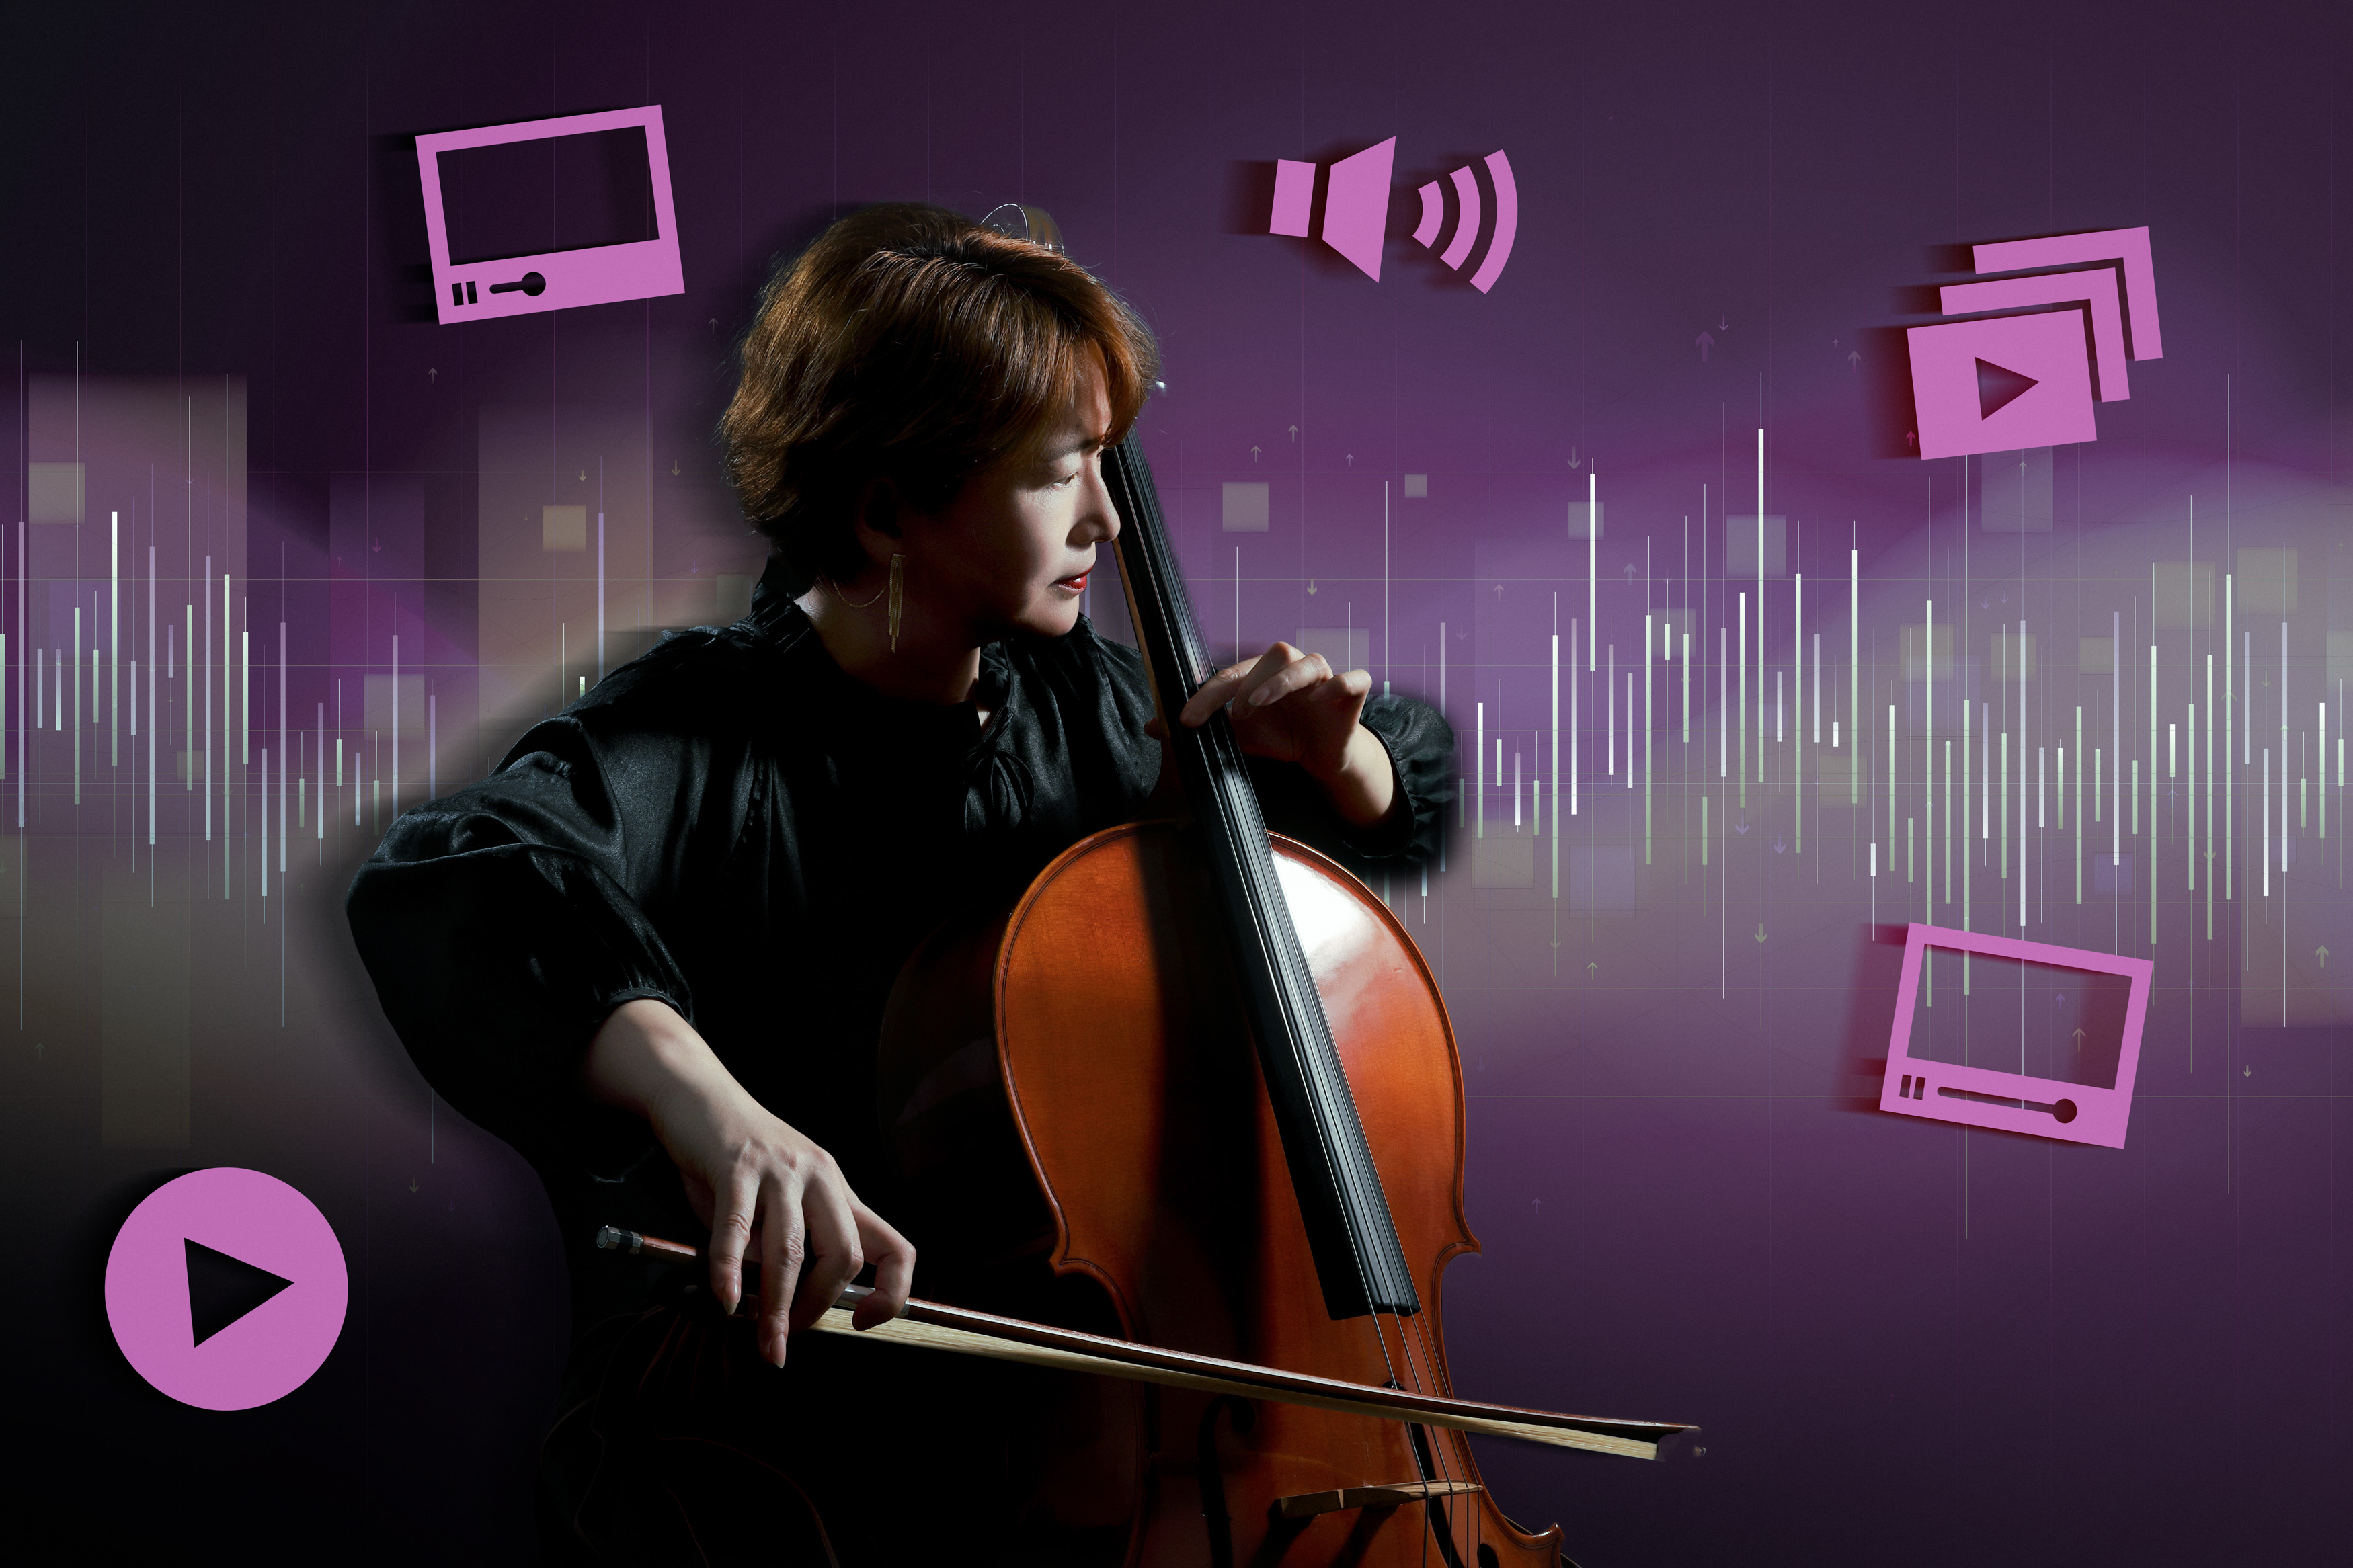
مردم به طور طبیعی با برقراری ارتباط بین بینایی و صدا یاد می گیرند. به عنوان مثال ، ما می توانیم کسی را تماشا کنیم که ویولن سل را بازی کند و اعتراف کند که حرکات سلولیست موسیقی را که می شنویم تولید می کند.
یک رویکرد جدید ، که توسط محققان MIT و جاهای دیگر تهیه شده است ، توانایی مدل AI را در یادگیری به همان روش بهبود می بخشد. این می تواند در برنامه هایی مانند روزنامه نگاری و تولید فیلم مفید باشد ، جایی که این مدل می تواند با بازیابی خودکار ویدیویی و صوتی به تحریک محتوای چند مدلی کمک کند.
در دراز مدت ، این کار می تواند برای بهبود توانایی ربات در درک محیط های واقعی که در آن اطلاعات شنوایی و بصری اغلب از نزدیک مرتبط هستند ، استفاده شود.
محققان با بهبود کار قبلی خود از گروه خود ، روشی را ایجاد کرده اند که به مدل های یادگیری ماشین کمک می کند تا داده های صوتی و تصویری مربوطه را از فیلم ها بدون نیاز به برچسب های انسانی برابر کنند.
آنها نحوه آموزش مدل اصلی خود را تنظیم کردند ، بنابراین او مکاتبات ریز و درشت تر بین یک قاب ویدیویی خاص و صوتی را که در آن لحظه اتفاق می افتاد ، آموخت. محققان همچنین برخی از مکث های معماری را انجام داده اند که به سیستم کمک می کند دو هدف آموزشی مختلف را متعادل کند و این باعث افزایش کارایی می شود.
روی هم رفته ، این پیشرفت های نسبتاً ساده ، دقت رویکرد آنها را به وظایف استخراج فیلم و طبقه بندی عملکرد در صحنه های سمعی و بصری افزایش می دهد. به عنوان مثال ، روش جدید می تواند به طور خودکار و دقیق با صدای درب مطابقت داشته باشد ، که توسط بسته شدن بصری در یک ویدیو رخ داده است.
“ما سیستم های هوش مصنوعی را می سازیم که می تواند جهان را پردازش کند ، زیرا مردم ، از نظر اطلاعات صوتی و تصویری ، یکباره وارد می شوند و می توانیم به راحتی هر دو روش را پردازش کنیم. ما انتظار داریم اگر بتوانیم این فناوری صوتی و تصویری را در برخی از ابزارهایی که هر روز استفاده می کنیم ادغام کنیم ، مانند الگوهای بزرگ زبانی ، Rouditchenko ، او می تواند یک دانش آموز را باز کند و می تواند بسیاری از برنامه های جدید را با استفاده از کاغذ Rouditchenko ، با استفاده از کاغذهای جدید ، او را باز کند.
وی توسط نویسنده اصلی ادسون آراجو ، دانشجوی فارغ التحصیل دانشگاه گوته در آلمان به روزنامه می پیوندد. یوان گونگ ، سابق MIT Postdoc ؛ Saurabhchand Bhati ، MIT Postdoc فعلی ؛ ساموئل توماس ، برایان کینگزبری و لئونید کارلیینسکی از تحقیقات IBM ؛ روجریو فریس ، دانشمند ارشد و مدیر آزمایشگاه MIT-BM Watson AI ؛ جیمز گلس ، دانشمند ارشد علمی و رئیس سیستم های زبان گفتاری در آزمایشگاه علوم کامپیوتر و هوش مصنوعی MIT (CSAIL) ؛ و نویسنده ارشد هیلد کین ، استاد علوم کامپیوتر در دانشگاه گوته و استاد وابسته در آزمایشگاه MIT-BM Watson AI. این کار در کنفرانس دیدگاه رایانه و تشخیص تصویر ارائه می شود.
همگام سازی
این کار بر اساس یک روش یادگیری ماشین است که محققان چند سال پیش توسعه داده اند ، که یک روش مؤثر برای آموزش یک مدل چند حالته برای داده های صوتی و تصویری همزمان بدون نیاز به برچسب های انسانی فراهم کرده است.
محققان این مدل را با نام Cav-Mae ، بدون فیلم های دارای برچسب ، تغذیه می کنند و داده های بصری و صوتی را به طور جداگانه در بازنمایی هایی به نام توکن رمزگذاری می کند. با استفاده از صدای طبیعی از ضبط ، مدل به طور خودکار یاد می گیرد که جفت های مناسب از نشانه های صوتی و تصویری را نزدیک به ارائه داخلی خود ترسیم کند.
آنها دریافتند که استفاده از دو هدف آموزشی ، روند آموزش مدل را متعادل می کند ، که به Cav-MAE اجازه می دهد تا داده های صوتی و تصویری مربوطه را درک کند ، ضمن اینکه توانایی آن در بازیابی فیلم هایی را که مطابق با درخواست کاربران است ، بهبود می بخشد.
اما Cav-Mae نمونه های صوتی و تصویری را به عنوان یک واحد درمان می کند ، بنابراین یک فیلم 10 ثانیه ای و صدای درب با هم نقشه برداری می شود ، حتی اگر این رویداد صوتی فقط در یک ثانیه از فیلم اتفاق بیفتد.
محققان در مدل بهبود یافته خود به نام Cav-Mae Sync ، قبل از محاسبه مدل داده های خود ، صدا را به ویندوزهای کوچکتر تقسیم می کنند تا ایده های فردی را که مطابق با هر پنجره صوتی کوچکتر است ، ایجاد کند.
در حین آموزش ، مدل یاد می گیرد که یک قاب ویدیویی را به صوتی وصل کند که فقط در این قاب اتفاق می افتد.
آراجو می گوید: “با انجام این کار ، مدل مکاتبات دقیق تری را می آموزد ، که به ارائه بعداً در خلاصه این اطلاعات کمک می کند.”
آنها همچنین شامل پیشرفت های معماری بودند که به مدل کمک می کند تا دو هدف آموزشی خود را متعادل کند.
“اتاق Blowfill” را اضافه کنید
این مدل شامل یک هدف متضاد است که در آن می آموزد داده های صوتی و تصویری مشابه و یک هدف بازسازی را به هم وصل کند ، که هدف آن بازگرداندن داده های صوتی و تصویری خاص بر اساس درخواست های کاربر است.
در همگام سازی CAV-MAE ، محققان برای بهبود توانایی آموزش مدل ، دو نوع داده یا نشانه جدید را معرفی کرده اند.
این موارد شامل “نشانه های جهانی” تخصصی است که به هدف آموزش متضاد و “نشانه های ثبت شده” تخصصی کمک می کند که به مدل کمک می کند تا روی جزئیات مهم در مورد هدف بازسازی تمرکز کند.
آروجو می افزاید: “در اصل ، ما اتاق Wiggle کمی بیشتر به مدل اضافه می کنیم تا بتواند هر یک از این دو کار را انجام دهد ، متضاد و بازسازی ، کمی مستقل تر. این از عملکرد کلی استفاده می کند.”
در حالی که محققان شهود خاصی داشتند ، این پیشرفت ها کار همگام سازی Cav-Mae را بهبود می بخشد ، برای جابجایی مدل در مسیری که می خواستند برود ، ترکیب دقیق استراتژی ها لازم بود.
رودیچیکو می گوید: “از آنجا که ما روشهای زیادی داریم ، برای هر دو روش به یک مدل خوب نیاز داریم ، اما باید آنها را نیز ادغام و همکاری کنیم.”
در پایان ، پیشرفت آنها توانایی مدل در استخراج فیلم ها بر اساس درخواست صوتی و پیش بینی کلاس صحنه صوتی و تصویری مانند سگ ها یا نواختن ساز را بهبود بخشید.
نتایج آن دقیق تر از کار قبلی آنها بود ، و همچنین بهتر از روشهای پیچیده تر و پیشرفته تر عمل می کرد که به مقادیر بیشتری از داده های آموزش نیاز دارند.
آروجو می گوید: “گاهی اوقات ایده های بسیار ساده یا مدل های کوچکی که در داده ها مشاهده می کنید ، در صورت استفاده از مدلی که روی آن کار می کنید از ارزش زیادی برخوردار هستند.”
در آینده ، محققان می خواهند مدل های جدیدی را درج کنند که ایده های بهتری را در همگام سازی Cav-Mae ایجاد می کنند که می تواند عملکرد را بهبود بخشد. آنها همچنین می خواهند به سیستم خود اجازه دهند داده های متنی را پردازش کند ، که این یک گام مهم در جهت تولید یک مدل سمعی و بصری به یک زبان بزرگ است.
این کار تا حدودی توسط وزارت آموزش و تحقیقات فدرال آلمان و آزمایشگاه MIT-BM Watson AI تأمین می شود.