در AI zeitgeist فعلی، محبوبیت مدلهای توالی به دلیل توانایی آنها در تجزیه و تحلیل دادهها و پیشبینی کارهای بعدی افزایش یافته است. به عنوان مثال، احتمالاً از مدلهای پیشبینی نشانه بعدی مانند ChatGPT استفاده کردهاید، که هر کلمه (ژتون) را به ترتیب پیشبینی میکند تا پاسخهایی به درخواستهای کاربر شکل دهد. همچنین مدلهای توزیع کامل دنبالهای مانند Sora وجود دارد که با «شیطانسازی» یک سکانس کامل ویدیویی، کلمات را به تصاویری خیرهکننده و واقعی تبدیل میکند.
محققان آزمایشگاه علوم محاسباتی و هوش مصنوعی MIT (CSAIL) اصلاح سادهای را در طرح یادگیری انتشار پیشنهاد کردهاند که این توالی حذف نویز را به طور قابل توجهی انعطافپذیرتر میکند.
هنگامی که در زمینههایی مانند بینایی کامپیوتر و روباتیک اعمال میشود، مدلهای انتشار توکن بعدی و توالی کامل دارای قابلیتهای مبادلهای هستند. الگوهای توکن بعدی میتوانند توالیهایی را که طول آنها متفاوت است، حذف کنند. با این حال، آنها این نسلها را بدون آگاهی از وضعیتهای مورد نظر در آینده دور انجام میدهند – مانند هدایت تولید توالی به یک هدف خاص در فاصله 10 توکن – و بنابراین به مکانیسمهای اضافی برای برنامهریزی بلندمدت (بلند مدت) نیاز دارند. مدلهای انتشار میتوانند چنین نمونهگیری احتمالی آینده را انجام دهند، اما فاقد توانایی مدلهای نشانه بعدی برای تولید دنبالههایی با طول متغیر هستند.
محققان CSAIL می خواستند نقاط قوت این دو مدل را با هم ترکیب کنند، بنابراین یک تکنیک آموزشی مدل توالی به نام “اجبار انتشار” ایجاد کردند. این نام از “اجبار معلم” گرفته شده است، یک طرح آموزشی مرسوم که تولید کامل یک دنباله را به مراحل کوچکتر و آسان تر تولید نشانه بعدی تقسیم می کند (مثل یک معلم خوب که یک مفهوم پیچیده را ساده می کند).
Diffusion Forcing وجوه مشترکی بین مدلهای انتشار و اجبار معلم پیدا کرد: هر دو از طرحهای آموزشی استفاده میکنند که شامل پیشبینی نشانههای ماسکدار (پر سر و صدا) از نمونههای بدون ماسک است. در مورد مدل های انتشار، آنها به تدریج نویز را به داده ها اضافه می کنند که می تواند به عنوان پوشاندن جزئی دیده شود. روش اجباری انتشار محققان MIT، شبکههای عصبی را آموزش میدهد تا مجموعهای از توکنها را تمیز کنند و مقادیر متفاوتی از نویز را در هر کدام حذف کنند و در عین حال چند توکن بعدی را پیشبینی کنند. نتیجه: یک مدل توالی انعطاف پذیر و قابل اعتماد که منجر به ویدیوهای مصنوعی با کیفیت بالاتر و تصمیم گیری دقیق تر برای ربات ها و عوامل هوش مصنوعی شد.
با مرتبسازی دادههای پر سر و صدا و پیشبینی قابل اعتماد مراحل بعدی در یک کار، Diffusion Forcing میتواند به ربات کمک کند تا حواسپرتیهای بصری را نادیده بگیرد تا کارهای دستکاری را کامل کند. همچنین میتواند توالیهای ویدیویی پایدار و ثابتی تولید کند و حتی یک عامل هوش مصنوعی را از طریق پیچ و خمهای دیجیتال هدایت کند. این روش به طور بالقوه می تواند ربات های خانگی و کارخانه ای را قادر سازد تا به کارهای جدید تعمیم داده و سرگرمی های تولید شده توسط هوش مصنوعی را بهبود بخشند.
هدف مدلهای توالی شرطی کردن گذشته شناخته شده و پیشبینی آینده ناشناخته، نوعی پوشش دوتایی است. با این حال، نیازی نیست که پوشش دودویی باشد.” با انتشار اجباری، سطوح مختلفی از نویز را به هر توکن اضافه میکنیم، که به طور موثر به عنوان نوعی پوشش جزئی عمل میکند. در طول آزمایش، سیستم ما میتواند مجموعهای از نشانهها را «پاکسازی» کند و دنبالهای را در آینده نزدیک در سطح پایینتری از نویز منتشر کند. می داند که برای غلبه بر ورودی های خارج از توزیع به چه چیزی باید اعتماد کند.
در چندین آزمایش، Diffusion Forcing قادر به نادیده گرفتن داده های گمراه کننده برای تکمیل وظایف در حین پیش بینی اقدامات آینده بود.
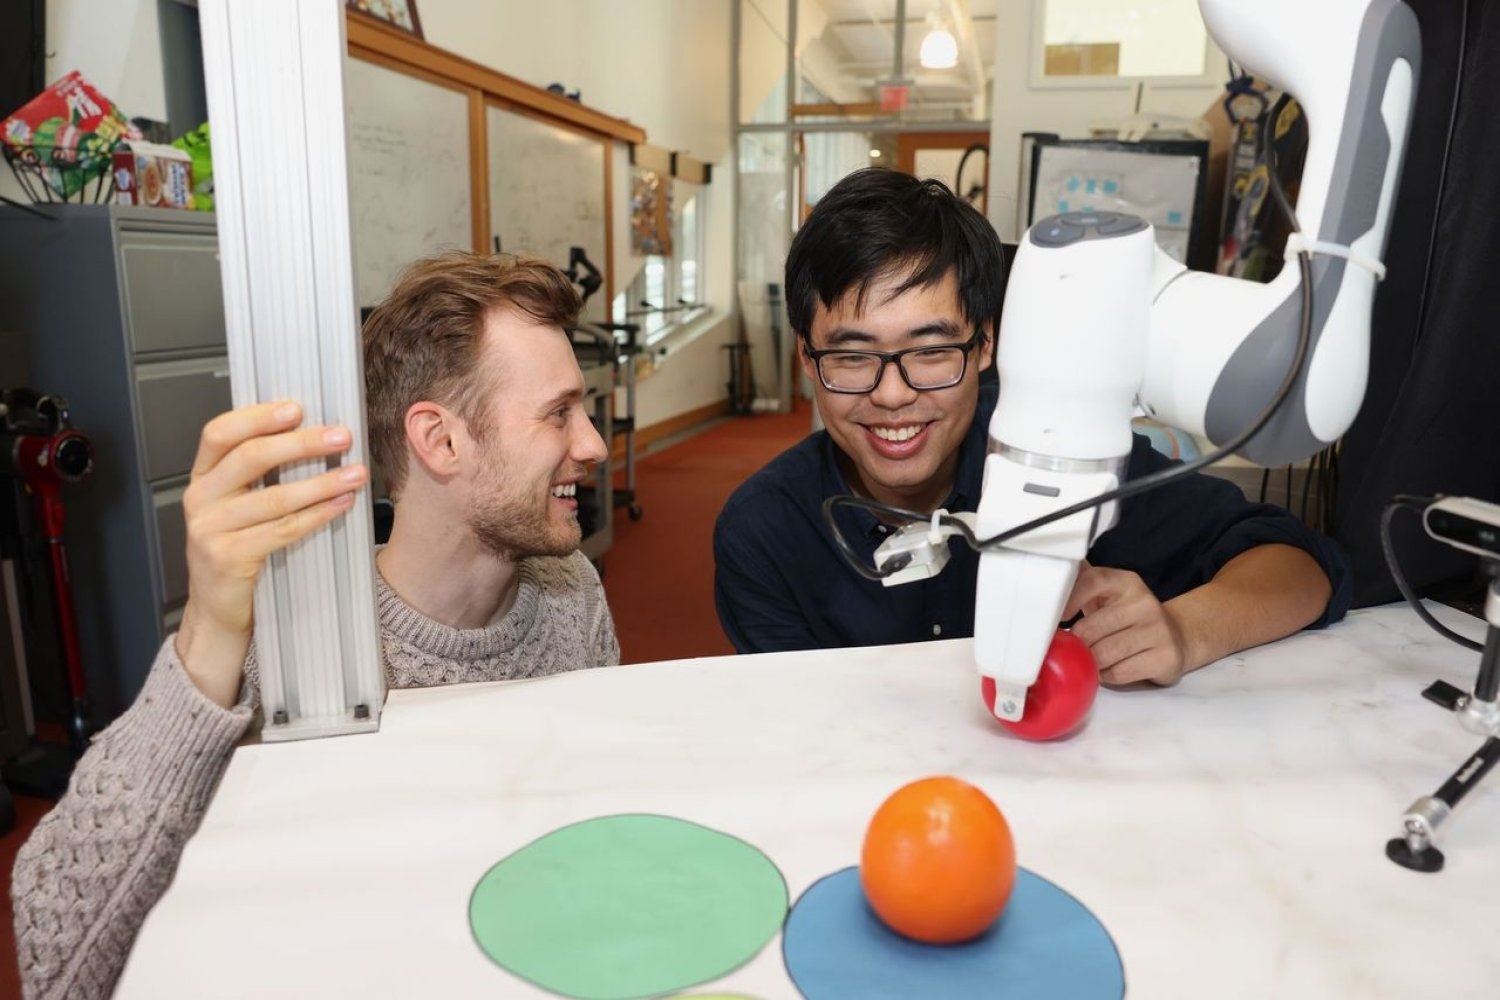
برای مثال، زمانی که در یک بازوی روباتیک اجرا شد، به تعویض دو میوه اسباببازی روی سه تشک گرد کمک کرد، نمونهای حداقلی از یک خانواده از کارهای افق بلند که نیاز به خاطرات دارند. محققان ربات را با کنترل از راه دور (یا کنترل از راه دور) در واقعیت مجازی آموزش دادند. این ربات برای تقلید حرکات کاربر از دوربین خود آموزش دیده است. اگرچه او از موقعیتهای تصادفی شروع میکند و حواسپرتیها را میبیند مانند یک کیسه خرید که نشانگرها را مسدود میکند، اما اشیا را در نقاط هدف خود قرار میدهد.
برای تولید این ویدئوها، آنها Diffusion Forcing را در یک بازی “Minecraft” و محیط های دیجیتال رنگارنگ ایجاد شده در شبیه ساز DeepMind Lab گوگل آموزش دادند. هنگامی که یک فریم از مواد ضبط شده به آن داده می شود، این روش ویدیوهای قوی تر و با وضوح بالاتری نسبت به خطوط پایه قابل مقایسه مانند مدل انتشار توالی کامل شبیه به Sora و مدل های توکن بعدی شبیه به ChatGPT تولید می کند. این رویکردها ویدیوهایی را تولید میکردند که به نظر ناسازگار به نظر میرسیدند، با این روشها گاهی اوقات موفق به تولید یک ویدیوی قابل اجرا تنها پس از ۷۲ فریم نمیشدند.
Diffusion Forcing نه تنها ویدیوهای خارقالعادهای تولید میکند، بلکه میتواند به عنوان یک برنامهریز حرکتی نیز عمل کند که نتایج یا پاداشهای مورد نظر را هدف قرار میدهد. با توجه به انعطافپذیری، Diffusion Forcing میتواند بهطور منحصربهفرد طرحهای افق متغیر ایجاد کند، جستجوهای درختی را انجام دهد و این شهود را در خود بگنجاند که آینده دور نامطمئنتر از آینده نزدیک است. در کار حل پیچ و خم دوبعدی، Diffusion Forcing با ایجاد طرحهای سریعتر منتهی به مکان هدف، از شش خط پایه بهتر عمل کرد، که نشان میدهد میتواند برنامهریزی مؤثری برای روباتها در آینده باشد.
در هر نمایش، Diffusion Forcing به عنوان یک مدل توالی کامل، یک مدل پیشبینی نشانه بعدی یا هر دو عمل میکند. به گفته چن، این رویکرد چند وجهی به طور بالقوه می تواند به عنوان ستون فقرات قدرتمندی برای یک “مدل جهانی” عمل کند، یک سیستم هوش مصنوعی که می تواند پویایی جهان را با یادگیری از میلیاردها ویدئو در اینترنت شبیه سازی کند. این به رباتها اجازه میدهد تا با تصور کارهایی که باید بر اساس محیط اطراف خود انجام دهند، وظایف جدیدی را انجام دهند. به عنوان مثال، اگر از یک ربات بخواهید بدون آموزش نحوه انجام آن، دری را باز کند، مدل می تواند ویدیویی ایجاد کند که نحوه انجام آن را به دستگاه نشان دهد.
این تیم در حال حاضر به دنبال گسترش روش خود به مجموعه داده های بزرگتر و آخرین مدل های ترانسفورماتور برای بهبود عملکرد است. آنها قصد دارند کار خود را برای ساختن مغز رباتی شبیه به ChatGPT گسترش دهند که به ربات ها کمک می کند تا وظایف خود را در محیط های جدید بدون نظارت انسان انجام دهند.
وینسنت سیتزمن، نویسنده ارشد، استادیار MIT و یکی از اعضای CSAIL، جایی که او گروه صحنهپردازی را رهبری میکند، میگوید: «با انتشار اجبار، گامی به سوی همگرایی تولید ویدیو و روباتیک برمیداریم. در نهایت، ما امیدواریم که بتوانیم از تمام دانش ذخیره شده در ویدیوهای موجود در اینترنت استفاده کنیم تا به روبات ها اجازه دهیم در زندگی روزمره کمک کنند. بسیاری از چالشهای تحقیقاتی هیجانانگیز باقی ماندهاند، مانند اینکه چگونه رباتها میتوانند با مشاهده انسانها، تقلید از آنها را یاد بگیرند، حتی زمانی که بدن خود آنها با بدن ما بسیار متفاوت است!»
چن و سیتزمن این مقاله را به همراه دیگو مارتی مونسو، محقق بازدیدکننده اخیر MIT و شرکای CSAIL نوشتند: ییلون دو، دانشجوی کارشناسی ارشد EECS. ماکس سیمهویتز، همکار سابق فوق دکترا و استادیار آینده در دانشگاه کارنگی ملون؛ و راس تدراک، پروفسور تویوتا EECS، هوانوردی و فضانوردی، و مهندسی مکانیک در MIT، معاون تحقیقات روباتیک در موسسه تحقیقات تویوتا، و عضو CSAIL. کار آنها تا حدی توسط بنیاد ملی علوم ایالات متحده، آژانس علوم و فناوری دفاعی سنگاپور، آژانس پروژه های تحقیقاتی پیشرفته از طریق وزارت کشور ایالات متحده و مرکز علمی آمازون حمایت شد. آنها تحقیقات خود را در NeurIPS در ماه دسامبر ارائه خواهند کرد.